
Databricks im Jahr 2026: Der strategische Pfeiler des Data-Driven-Unternehmens
Im volatilen Umfeld des Jahres 2026 hängt die Überlebens- und Führungsfähigkeit eines Unternehmens nicht davon ab, wie viele Daten es anhäuft, sondern von der Geschwindigkeit und Sicherheit, mit der es diese in rentable Entscheidungen umwandelt. Für Technologie- und Wirtschaftsführer liegt die Herausforderung nicht mehr in der Infrastruktur, sondern in der Fragmentierung: Datensilos, unkontrollierte Cloud-Kosten und eine künstliche Intelligenz, die oft in der Experimentierphase stecken bleibt.
Databricks ist kein Nischenwerkzeug mehr, sondern hat sich zum Betriebssystem des modernen Unternehmens entwickelt. Durch die Vereinigung von Data Engineering, analytischer Speicherung und generativer KI in einer einzigen offenen Architektur (Lakehouse) ermöglicht es Ihrem Unternehmen, sich nicht mehr mit der Verwaltung komplexer Systeme aufzuhalten, sondern sich auf die Schaffung von Wettbewerbsvorteilen zu konzentrieren.
In diesem Artikel analysieren wir, warum Databricks heute die Schlüsselkomponente ist, um Ihren technologischen ROI zu optimieren, den Zugang zu Informationen zu demokratisieren und Innovationen mit vollständiger Governance zu skalieren.
Die Konsolidierung des Data Lakehouse als operativer Standard
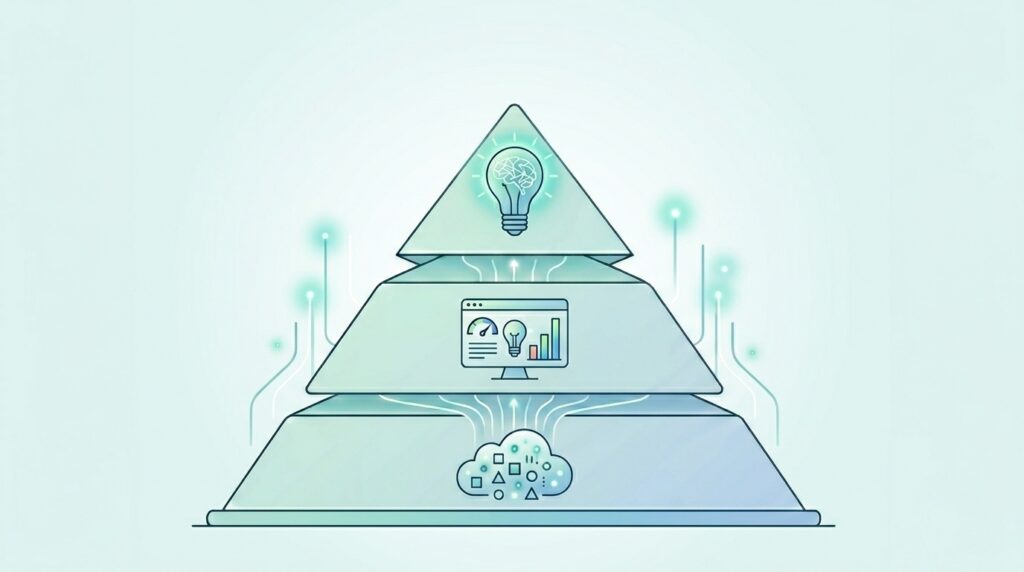
Im Jahr 2026 ist die Unterscheidung zwischen einem Data Warehouse (für strukturierte Analysen) und einem Data Lake (für Data Science) obsolet geworden. Die Lakehouse-Architektur von Databricks hat sich als Standard etabliert, da sie Datenredundanz und operative Silos eliminiert, die früher Innovationen bremsten.
Dies lässt sich in drei grundlegende Pfeiler unterteilen:
-
Vereinfachung der Infrastruktur: Sie müssen nicht mehr zwei kritische Systeme warten oder für den Datentransfer zwischen ihnen bezahlen (komplexe ETL). Alles befindet sich an einem einzigen Ort unter offenen Standards wie Delta Lake.
-
Reaktionsschnelligkeit: Da Engineering- und Geschäftsdaten auf einer einzigen Plattform vorliegen, verkürzt sich die Zeit von der Datenerzeugung bis zur Entscheidungsfindung drastisch.
-
Offene Architektur: Im Gegensatz zu geschlossenen Lösungen garantiert das Lakehouse, dass Sie Eigentümer Ihrer Daten bleiben. Dies verhindert einen Vendor Lock-in und ermöglicht die völlig freie Integration von Drittanbieter-Tools.
Das Lakehouse ist nicht nur eine technische Verbesserung, sondern die Beseitigung interner Reibungsverluste. Wenn Ihre Analyse- und KI-Teams nicht dieselbe „Datensprache“ sprechen, verliert Ihr Unternehmen gegenüber dem Wettbewerb an Geschwindigkeit.
Mosaic AI: Einsatz generativer künstlicher Intelligenz mit eigenen Daten
Im Jahr 2026 bietet generische KI keinen Wettbewerbsvorteil mehr. Der wahre Wert liegt in Mosaic AI, der Suite von Databricks, die es Unternehmen ermöglicht, Sprachmodelle (LLMs) unter Verwendung ihres geistigen Eigentums sicher zu trainieren und anzupassen.
Im Gegensatz zu „Black-Box“-Lösungen erleichtert Mosaic AI das RAG (Retrieval-Augmented Generation) in großem Maßstab und stellt sicher, dass KI-Antworten in realen Geschäftsdaten verankert sind und nicht auf Halluzinationen beruhen.
-
Vollständige Personalisierung: Trainieren Sie Modelle mit Ihrer technischen Terminologie und historischen Daten.
-
Garantierter Datenschutz: Ihre Daten verlassen niemals Ihre kontrollierte Umgebung, um Modelle Dritter zu trainieren.
-
Effizienz der Inferenz: Kostenoptimierung, damit der Einsatz eines intelligenten Assistenten Ihre Computing-Rechnung nicht in die Höhe treibt.
Unity Catalog: Umfassende Governance und Sicherheit in Multi-Cloud-Umgebungen
In der Technologielandschaft von 2026 hat sich Unity Catalog als die definitive Lösung für die Verwaltung von Daten und künstlicher Intelligenz in hybriden Cloud-Architekturen etabliert. Heutige Organisationen agieren in komplexen Ökosystemen und benötigen eine zentrale Steuerung, die Sicherheitslücken verhindert.
Unity Catalog eliminiert die Komplexität fragmentierter Berechtigungsverwaltung und bietet eine klare Sicht auf den gesamten Datenbestand.
Einheitliche Kontrolle für Daten und künstliche Intelligenz
Im Gegensatz zu herkömmlichen Governance-Tools ermöglicht Unity Catalog die Verwaltung von Berechtigungen für Tabellen und Sprachmodelle von einem einzigen Zugriffspunkt aus. Diese Fähigkeit stellt sicher, dass Compliance-Richtlinien konsistent in der gesamten Unternehmensstruktur angewendet werden. Das System ermöglicht die Prüfung, wer auf Informationen zugreift, und stellt sicher, dass nur autorisiertes Personal mit sensiblen Assets interagiert.
Rückverfolgbarkeit und automatisierte Lineage
Die Data Lineage ermöglicht es, den exakten Weg der Informationen von der ersten Erfassung bis zum finalen Geschäftsbericht nachzuvollziehen. Diese Funktion ist grundlegend für die Einhaltung internationaler Datenschutzbestimmungen und zur Validierung der Qualität der von der KI generierten Ergebnisse. Dank dieser Transparenz können technische Teams die Ursache jeder Anomalie in Sekundenschnelle identifizieren.
Sichere Zusammenarbeit durch Delta Sharing
Die Funktionalität von Delta Sharing erleichtert den Austausch von Daten-Assets mit Lieferanten und externen Kunden in Echtzeit. Dieser Prozess erfolgt sicher und erfordert keine Erstellung physischer Kopien der Informationen in anderen Systemen. Durch die Verwendung offener Standards wird eine reibungslose Zusammenarbeit gefördert, die Innovationen vorantreibt, ohne das geistige Eigentum zu gefährden.
Governance im Jahr 2026 ist kein Hindernis mehr für Agilität. Mit Unity Catalog wird die Einhaltung gesetzlicher Vorschriften zu einem strategischen Vorteil, der absolutes Vertrauen in Entscheidungsprozesse schafft.
Databricks SQL: Demokratisierung des Zugangs zu Insights in Echtzeit
Aktuell ist die Barriere zwischen Datenspeicherung und Geschäftsanalyse vollständig verschwunden. Databricks SQL ermöglicht es Analysten und Entscheidungsträgern, das Lakehouse direkt mit der Leistung eines traditionellen Data Warehouse abzufragen. Es ist nicht mehr notwendig, Informationen in externe Systeme zu verschieben, um schnelle Antworten zu erhalten.
Diese technologische Entwicklung stellt sicher, dass Daten denjenigen zur Verfügung stehen, die sie wirklich benötigen, ohne auf ständige Exportprozesse angewiesen zu sein.
Elite-Performance mit der Photon-Engine
Die Photon-Engine hat die Erwartungen an die Geschwindigkeit bei der Abfrageverarbeitung neu definiert. Dank ihrer vektorbasierten Ausführung werden Aggregations- und Filteraufgaben selbst bei Petabyte-Volumen in Millisekunden erledigt. Diese Effizienz eliminiert Wartezeiten, die früher die Produktivität von Finanz- oder Marketingabteilungen belasteten.
Simplizität durch Serverless-Architektur
Die Serverless-Modalität von Databricks SQL macht die Konfiguration oder Verwaltung komplexer Infrastrukturen überflüssig. Das System skaliert automatisch, um Nachfragespitzen abzufangen, und schaltet sich ab, wenn keine Aktivität erkannt wird. Dieses Modell der tatsächlichen nutzungsbasierten Abrechnung ermöglicht eine absolute Budgetkontrolle, ohne die Reaktionsfähigkeit bei Unvorhergesehenem zu opfern.
Integrierte KI-Funktionen für alle Profile
Eine der größten aktuellen Innovationen ist die Fähigkeit, KI-Modelle über einfache SQL-Befehle aufzurufen. Benutzer können Sentiment-Analysen oder Textklassifizierungen durchführen, ohne Code in Python zu schreiben. Diese Integration legt die Macht fortschrittlicher KI in die Hände jedes Profis mit grundlegenden Datenbankkenntnissen.
Der demokratische Zugang zu Informationen reduziert Reibungsverluste zwischen Abteilungen. Im Jahr 2026 ist ein Unternehmen, das Tage benötigt, um einen Bericht zu erhalten, ein Unternehmen, das in einem Markt, der sich in Sekunden bewegt, nicht konkurrieren kann.
TCO-Optimierung: Maximierung der Kosteneffizienz in großem Maßstab
Wirtschaftlicher Druck zwingt Unternehmen dazu, jeden Cent ihrer Cloud-Investition zu rechtfertigen. Databricks hat sich zu einer Plattform entwickelt, die nicht nur leistungsstark, sondern auch langfristig finanziell nachhaltig ist. Die Effizienz der Gesamtbetriebskosten (TCO) wird durch Automatisierung und radikale Vereinfachung der Datenarchitektur erreicht.
Serverless Computing und echte nutzungsbasierte Abrechnung
Cluster, die eingeschaltet bleiben, ohne produktive Aufgaben zu erfüllen, gehören der Vergangenheit an. Serverless Computing skaliert sofort nach Bedarf und schaltet sich exakt in dem Moment ab, in dem die Verarbeitung endet. Diese Fähigkeit eliminiert unnötige Ausgaben für inaktive Ressourcen, die früher die monatlichen Infrastrukturrechnungen aufblähten.
Konsolidierung von Werkzeugen und Reduzierung von ETL-Prozessen
Die Beibehaltung einer einzigen Plattform für Data Engineering und Analytik macht das Verschieben von Informationen zwischen heterogenen Systemen überflüssig. Durch die Arbeit auf dem Lakehouse spart man Speicherkosten durch Vermeidung von Daten-Duplikaten und Lizenzgebühren durch Reduzierung spezialisierter Anbieter. Weniger Datenbewegung bedeutet auch weniger Fehler und eine direkte Reduzierung der erforderlichen technischen Wartungsstunden.
Die Auswirkungen von Photon auf die Computing-Rechnung
Die Ausführungs-Engine Photon beschleunigt Arbeitslasten durch vektorbasierte Verarbeitung drastisch. Durch die schnellere Datenverarbeitung werden weniger abrechenbare Computing-Stunden beim Cloud-Anbieter verbraucht. Diese technische Effizienz führt zu einer Senkung der Betriebskosten, die bei großflächigen Prozessen im Vergleich zu herkömmlichen Infrastrukturen bis zu 40 % erreichen kann.
Die Senkung der TCO besteht nicht einfach darin, weniger auszugeben. Das eigentliche Ziel ist es, operative Verschwendung zu eliminieren, um dieses Kapital in Innovationen und KI-Projekte zu reinvestieren.
Roadmap 2026: Wie Sie Ihren Stack mit Databricks in ein Wettbewerbs-Asset verwandeln
Der Übergang von einer fragmentierten Dateninfrastruktur zu einer einheitlichen Plattform ist kein rein technischer Prozess. Im Jahr 2026 hängt der Erfolg von einer phasenweisen Umsetzung ab, die die technologische Architektur an den Rentabilitätszielen des Unternehmens ausrichtet. Eine intelligente Roadmap priorisiert den Abbau technischer Schulden und ermöglicht gleichzeitig den sofortigen Einsatz generativer KI-Fähigkeiten.
Phase 1: Audit von Silos und Migration zu Delta Lake
Der erste Schritt besteht darin, zu identifizieren, wo kritische Informationen liegen, und diese unter dem offenen Standard von Delta Lake zu konsolidieren. Diese Phase macht die Wartung isolierter Systeme überflüssig und stellt sicher, dass die Daten die notwendige Qualität haben, um KI-Modelle zu speisen. Durch die Vereinheitlichung der Speicherung wird eine solide Basis geschaffen, die den gleichzeitigen Zugriff für prädiktive Analysen und Data Science ohne Versionskonflikte ermöglicht.
Phase 2: Automatisierung von Governance und Compliance
Sobald die Assets zentralisiert sind, muss Unity Catalog implementiert werden, um die Sicherheit automatisiert zu verwalten. In dieser Phase definiert die Organisation, wer Zugriff auf welche Daten hat, und überwacht die vollständige Lineage der Informationen in hybriden Cloud-Umgebungen. Diese Kontrollstruktur ist grundlegend, um geltende Datenschutzbestimmungen einzuhalten und sicherzustellen, dass die künstliche Intelligenz auf wahrheitsgetreuen und autorisierten Daten operiert.
Phase 3: Aktivierung proprietärer künstlicher Intelligenz
Mit einer kontrollierten Datenbasis verlagert sich der Fokus auf die Wertschöpfung durch Mosaic AI. Diese Phase beinhaltet die Anpassung von Sprachmodellen mit dem geistigen Eigentum des Unternehmens, um spezifische Geschäftsprobleme zu lösen. Ziel ist es, intelligente Assistenten und automatisierte Prozesse zu integrieren, die die Entscheidungsfindung in Echtzeit verbessern und einen nachhaltigen Wettbewerbsvorteil gegenüber denjenigen bieten, die generische Lösungen nutzen.
Der strategische Einsatz im Jahr 2026 erfordert eine klare Sicht auf Kosten und Nutzen. Eine etappenweise Implementierung stellt sicher, dass jede Investition in Databricks zu einer messbaren Verbesserung der operativen Effizienz führt.
Warum Sie LISDATA als Databricks-Partner vertrauen sollten
Die Implementierung einer so leistungsstarken Architektur wie des Lakehouse im Jahr 2026 erfordert einen Verbündeten, der technische Meisterschaft mit tiefem Verständnis der Unternehmenslandschaft kombiniert. Bei LISDATA konfigurieren wir nicht nur Werkzeuge, sondern entwerfen Daten-Ökosysteme, die darauf ausgerichtet sind, Ihre Rentabilität und Innovationsfähigkeit zu maximieren.
Ein spezialisierter Partner stellt sicher, dass der Übergang zu Databricks reibungslos verläuft und bereits in den frühen Phasen messbare Ergebnisse liefert.
Vertikale Spezialisierung auf Logistik und Industrie
Unsere Erfahrung als Spezialisten für Logistik-, Industrie- und Transportberatung ermöglicht es uns, die spezifischen Herausforderungen Ihres Sektors zu verstehen. Wir wenden vertikale Lösungen an, die reale Probleme der Lieferkette und Produktion durch fortschrittliche Datenanalyse lösen. Diese sektorale Vision garantiert, dass sich die Databricks-Architektur an die operativen Bedürfnisse Ihres Unternehmens anpasst und nicht umgekehrt.
Personalisierte Projekte mit End-to-End-Fokus
Wir entwickeln maßgeschneiderte Projekte, die den gesamten Lebenszyklus der Informationen abdecken: von der ersten Erfassung und Verarbeitung im Lakehouse bis zur Aktivierung der Daten durch KI. Dieser ganzheitliche Ansatz stellt sicher, dass keine Kommunikationslücken zwischen Data Engineering und strategischer Entscheidungsfindung entstehen. Jede Lösung wird mit Blick auf Skalierbarkeit und die Schaffung hochwertiger digitaler Assets für Ihr Unternehmen entwickelt.
Schnelle Implementierung und Ergebnisorientierung
In einem so volatilen Umfeld wie dem heutigen ist die Ausführungsgeschwindigkeit ein kritischer Wettbewerbsvorteil. Wir zeichnen uns durch eine schnelle Implementierung technologischer Lösungen aus, die es unseren Kunden ermöglicht, in kurzer Zeit greifbare Vorteile zu erzielen. Unsere hohe technische Spezialisierung verbindet sich mit einer konstanten strategischen Vision, um sicherzustellen, dass jede Entwicklung direkt das Betriebsergebnis beeinflusst.
Der Erfolg von Databricks in Ihrer Organisation hängt von der Strategie ab, die dahintersteht. Bei LISDATA arbeiten wir daran, dass sich Ihre Investition in Daten heute in die Marktführerschaft von morgen verwandelt. Können wir Ihnen helfen?